文档
简介
JVMind 是一款 AI 驱动的对话式助手,用于 Java 虚拟机(JVM)性能问题排查。上传你的 GC 日志或线程转储,用自然语言提问,即可获得带有可执行建议的专业诊断报告。
无需手动解析成千上万行日志,也不必在庞大的线程转储里翻找死锁——上传文件,让 AI 来干重活:它会逐步分析数据,并用通俗的语言解释发生了什么。
核心功能
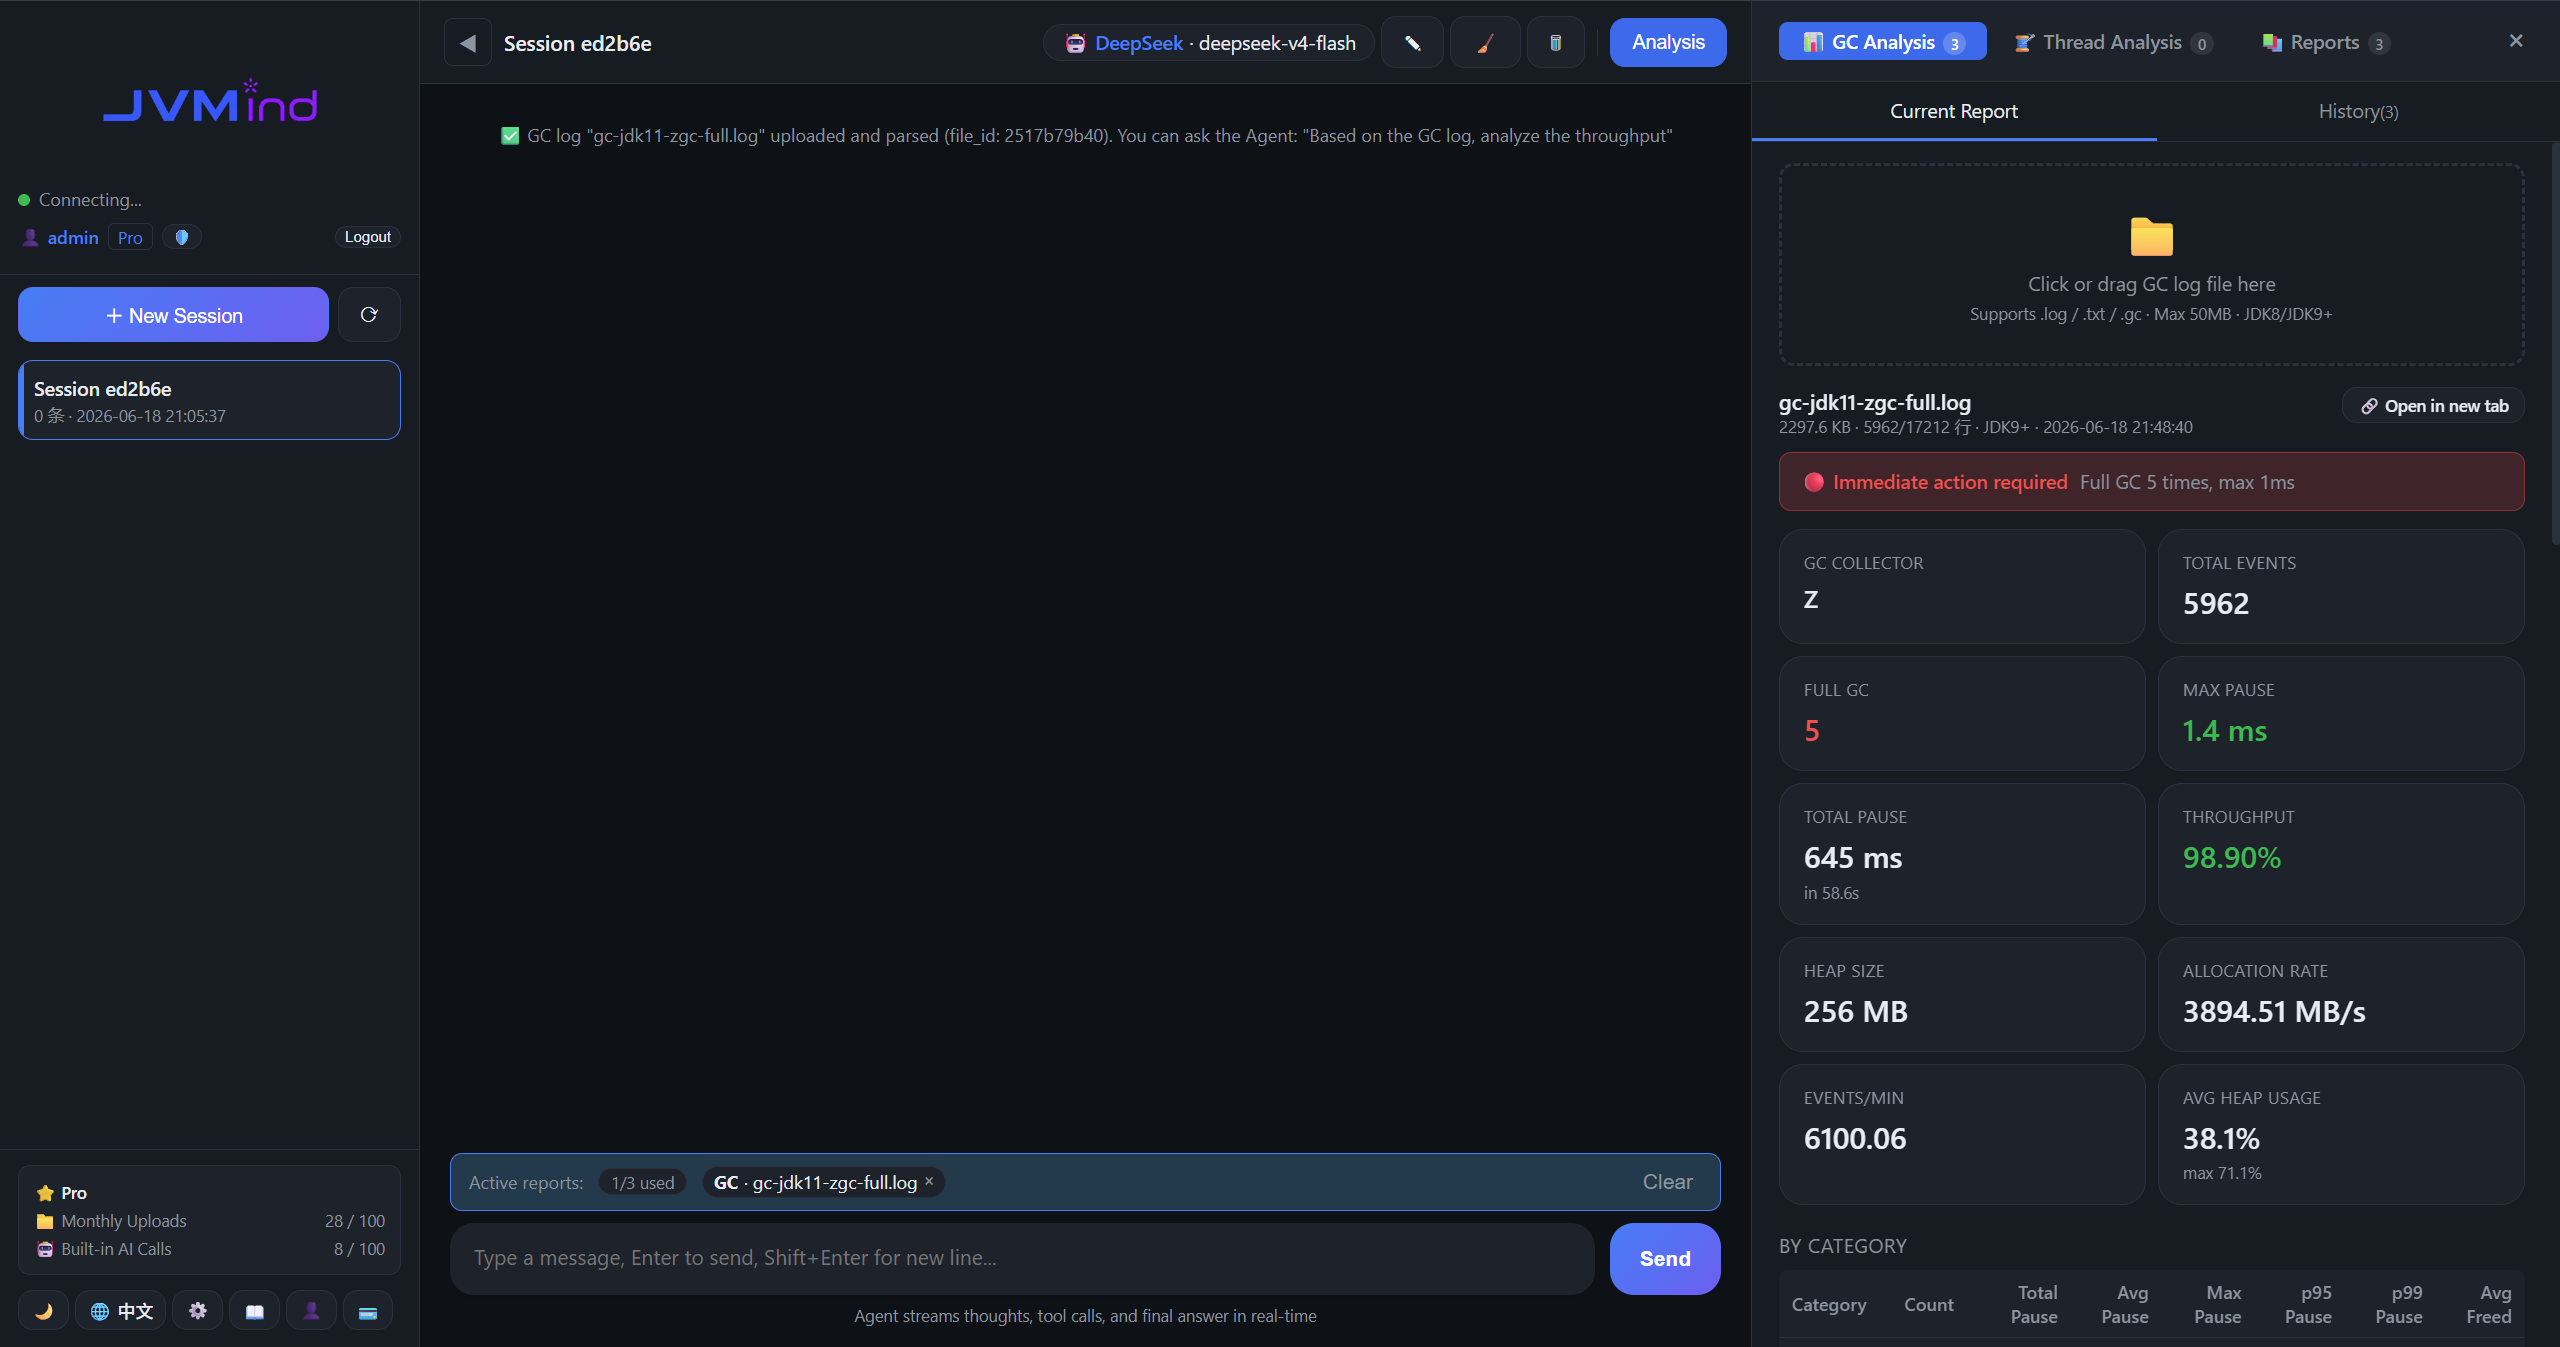
GC 日志分析
上传 GC 日志即可获得自动统计——吞吐量、停顿时间、收集器识别、最慢的 GC 事件,以及可视化图表。
线程转储分析
上传 jstack 输出,检测死锁、定位锁竞争热点,并生成堆栈火焰图。
AI 驱动对话
用自然语言就分析结果提问。AI 采用 ReAct 推理,逐步拆解复杂问题。
可视化图表
堆内存使用曲线、停顿时间分布与交互式火焰图——全部自动生成。
长期记忆
JVMind 会跨会话记住你的环境信息,随着时间推移给出更贴合上下文的回答。
灵活的 LLM 后端
支持 OpenAI、DeepSeek、通义千问、Kimi——或任何兼容 OpenAI 协议的 API。
GC 日志分析
如何生成 GC 日志
上传之前,请确认你的 JVM 已配置输出 GC 日志:
| JDK 8 | -XX:+PrintGCDetails -Xloggc:gc.log |
| JDK 9+ | -Xlog:gc*:file=gc.log |
如何分析
- 新建会话,或切换到已有会话
- 点击顶栏的 分析 按钮打开分析面板
- 在 GC 标签页中拖入 GC 日志文件,或点击选择文件
- 等待分析完成——你会看到统计数据和图表出现
- 在对话中让 AI 诊断:“请分析这份 GC 日志并给出优化建议”
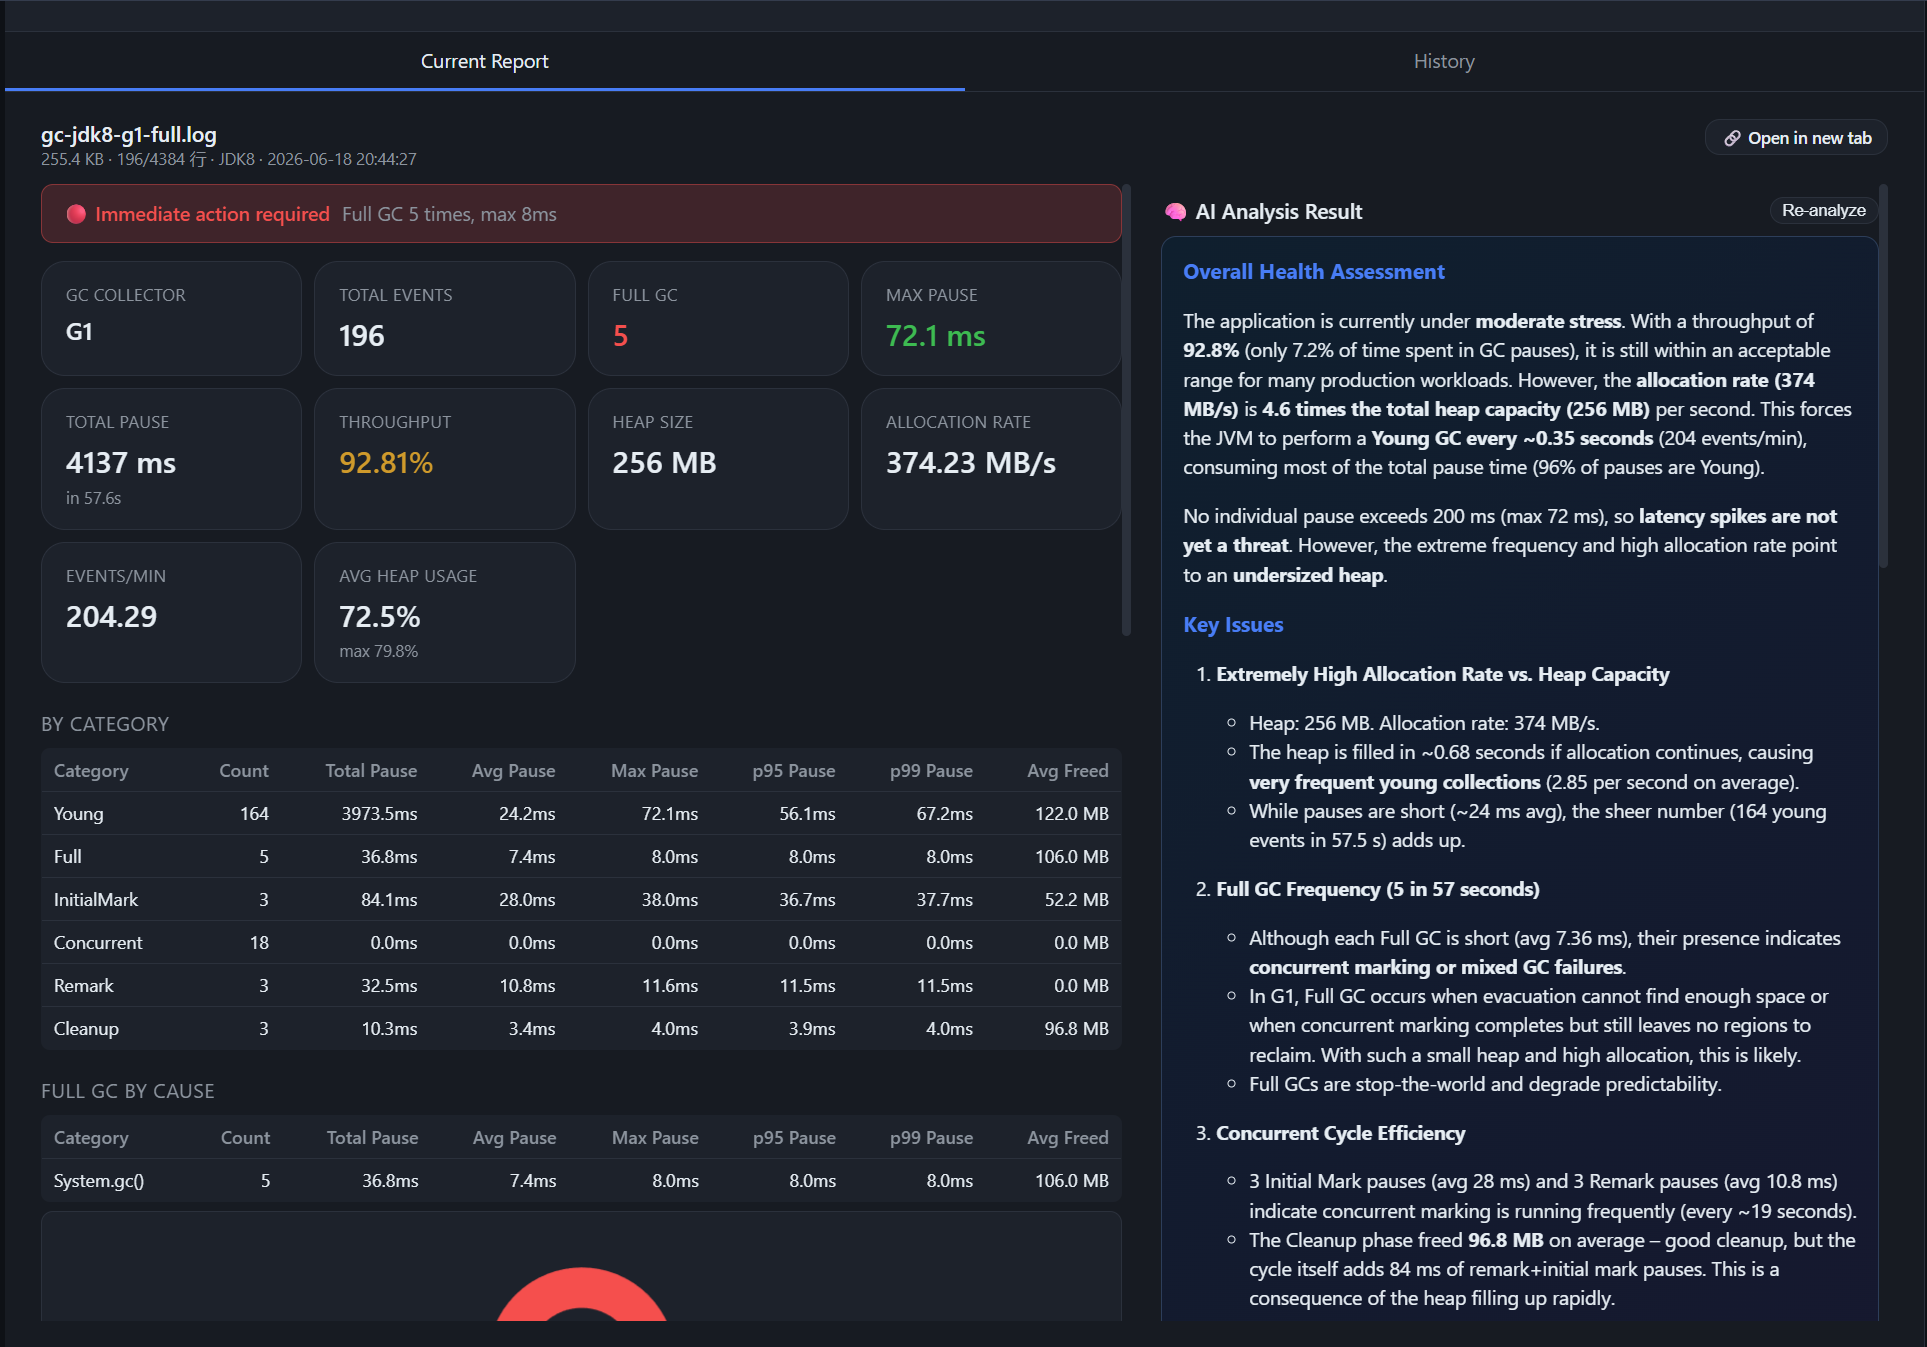
分析内容
- 收集器识别——自动检测 G1、Parallel、Serial、Shenandoah 或 ZGC
- 堆内存摘要——最小、最大与平均堆使用量
- GC 统计——按类别计数(Young、Mixed、Full)
- 吞吐量——应用运行时间与 GC 停顿时间的占比
- 停顿时间分析——总计、平均、P95、P99 分位数
- 最慢 Top 10——停顿时间最长的 GC 事件
- Full GC 触发原因——每次 Full GC 触发原因的明细
- 图表——堆使用时间线、停顿时间分布直方图
提示:为了获得最佳的 AI 诊断效果,请先上传 GC 日志,再在对话中提问。AI 会自动引用已上传的分析数据。
可以这样提问
- “吞吐量是多少?健康吗?”
- “为什么有这么多 Full GC?”
- “看看这是不是内存泄漏”
- “要减少 Young GC 停顿时间,我应该调整什么?”
诊断规则
JVMind 的 GC 分析建立在一个包含 14 条专家规则 的规则库之上,用于识别特定症状并给出严重级别。每份报告随后会归纳为一个根因,并配以两层支撑发现:直接证据与下游症状。本节记录这些规则,让你明白每种检测意味着什么、何时需要采取行动。
规则按适用的垃圾收集器分组。通用规则 对每个收集器都会运行;收集器专属规则 仅在日志被识别为该收集器时触发。
根因类别
每份报告都会产出且仅产出一个根因:
| 类别 | 含义 | 判定条件 |
|---|---|---|
oom |
堆内存无法释放空间——濒临崩溃。 | Full GC 且回收率 < 5%,或 ZGC 分配停顿 / 周期失败。 |
leak |
堆内存趋势恶化但尚未 OOM。趁还没变成 OOM 之前先排查。 | Mixed GC 跟不上对象晋升,或 Full GC 时堆仍有空间却无法分配连续内存块(CMS 碎片化)。 |
performance |
GC 压力(停顿高 / 频率高 / 吞吐低)。堆仍能恢复——调整收集器配置。 | 任何通用性能规则触发,或任何 CMS/ZGC 规则在无 reclaim_low 的情况下触发。 |
healthy |
没有规则触发。一切正常。 | 没有中/高严重级别的发现。 |
健康状态横幅级别
每份报告顶部的彩色横幅由根因类别与当前发现的严重级别共同决定。用词与下方诊断保持一致——横幅绝不会在诊断说“性能问题”时显示“严重”。
| 根因 | 横幅级别 | 说明 |
|---|---|---|
oom | 🔴 需立即处理 | 始终为严重。终态。 |
leak + 高严重级别发现 | 🔴 需立即处理 | 堆内存趋势正走向 OOM。 |
leak + 中严重级别发现 | 🟡 需关注 | 需密切监控。 |
performance + 任意发现 | 🟡 需关注 | 上限为警告——性能问题不等于即将崩溃。 |
healthy + 原始统计极端 | 🟡 需关注 | 规则遗漏时的安全网(堆 ≥ 98%,Full GC > 3 次)。 |
healthy + 统计正常 | 🟢 健康 | 一切正常。 |
通用规则
对所有收集器生效。每条规则基于聚合统计独立触发。
| 规则 ID | 触发条件 | 严重级别阈值 | 输出 |
|---|---|---|---|
throughput_low |
应用吞吐量(1 − 停顿占比)低于阈值。 | 中 < 95% | 高 < 90% | “应用吞吐量 X%,低于 Y 阈值” |
stw_time_ratio_high |
GC 停顿时间占日志总时长比例过大。 | 中 > 5% | 高 > 10% | “GC 停顿占日志时长的 X%” |
gc_frequency_high |
Young GC 或 Full GC 频率高于阈值。对于 Full GC,仅统计非手动触发——System.gc() / heap dump / heap inspection 被排除(改由 explicit_gc_called 处理)。Full GC 的严重级别考虑样本量:次数 < 3 → 不告警;次数 3-4 且频率高 → 中;次数 ≥ 5 且频率高 → 高。详情文本会提及日志时长以提供短窗口上下文。 |
Young:中 30/分,高 60/分 | Full:频率 > 0.2/分 + 次数 ≥ 3 → 中;次数 ≥ 5 → 高 | “Full GC X/分,共 N 次,约每 Y 秒一次” + 时长上下文(例如“日志仅覆盖 25 秒——样本较小,可能只是暂时现象”) |
reclaim_low |
Full 或 Mixed GC 的平均回收率(释放 / GC 前堆)低于阈值。 | avg_reclaim_ratio < 5%(≤ 2% → 高) | “Full GC 回收率仅 X%” |
explicit_gc_called |
由 System.gc() 触发的 Full GC(应用代码调用,而非堆压力)。 |
≥ 1 → 中;≥ 3 → 高 | “Full GC 由 System.gc() 触发——建议 -XX:+DisableExplicitGC” |
single_pause_long |
单次 GC 停顿超过该类别的阈值(Young 200/500ms、Full 1000/3000ms、ZGC 1/5ms、Shenandoah 100/200ms,……)。 | 按类别(Young / Mixed / Full / ZGC / Shenandoah / …) | “GC#N 停顿 Xms,超过 Y 阈值” |
G1 专属规则
仅在收集器被识别为 G1 时触发。
| 规则 ID | 触发条件 | 严重级别阈值 | 输出 |
|---|---|---|---|
g1_full_gc |
G1 正常情况下不应产生 Full GC。一旦出现,即为异常信号。 | 1-2 → 中;≥ 3 → 高(手动触发时上限为中;手动 + 压力混合的情况保持高) | “G1 发生 N 次 Full GC……”;当检测到 to-space exhausted / evacuation failure 时附带额外详情。全部为手动触发时,详情会说明;混合时,详情会分别列出手动与真实压力的次数。 |
g1_mixed_ineffective |
多次 Mixed GC 事件且 GC 前堆持续上升。 | ≥ 3 次事件,斜率 > 0.5 MB/次 → 中 | “Mixed GC 前堆持续上升——增量回收不足” |
g1_compaction_pause |
G1 主动全堆压缩(真实堆压力,G1 无法通过正常的 Mixed GC 回收)。 | ≥ 1 → 中;≥ 3 → 高 | “G1 触发全堆压缩——Mixed GC 跟不上对象晋升,堆已满” |
evacuation_failure (通用规则) |
G1 Young/Mixed GC 找不到 Survivor 空间容纳晋升对象(老年代已满的前兆信号)。 | ≥ 3 → 中;≥ 10 → 高 | “G1 Young/Mixed GC 无法为晋升对象找到 Survivor 空间——Full GC 的前兆” |
g1_humongous_allocation |
频繁的大对象分配(G1 humongous object,易造成老年代碎片化)。 | ≥ 10 → 中;≥ 30 → 高 | “频繁分配大对象——G1 为每个 humongous 对象分配整个 region,可能造成老年代碎片化并触发 Full GC” |
CMS 专属规则
仅在收集器被识别为 CMS 时触发。
| 规则 ID | 触发条件 | 严重级别阈值 | 输出 |
|---|---|---|---|
cms_full_gc |
检测到 CMS Full GC——覆盖 JDK9+ 统一日志的 Garbage Collection (X) 与 JDK8 经典的 [Full GC (X)] 格式,将 X 解析为 heap inspection initiated gc、heap dump initiated gc、system.gc() 或 allocation failure。并区分手动触发(jmap / jcmd / 应用代码)与真实堆压力(Allocation Failure / Promotion Failed)。 |
全部手动 → 中;混合 / 真实压力:≥ 3 → 高 | 否则为中 | “CMS Full GC:2 次手动(inspect)+ 3 次真实(Allocation Failure)” |
cms_concurrent_mode_failure |
Full GC 原因包含 concurrent mode failure——CMS 并发周期未能完成。 |
≥ 1 → 高 | “CMS 并发周期未能完成,堆已耗尽” |
cms_promotion_failed |
Full GC 原因包含 promotion failed——新生代对象无法放入老年代。 |
≥ 1 → 高 | “新生代对象无法放入老年代” |
cms_remark_too_long |
CMS Remark 阶段 p95 超过阈值。 | 中 p95 > 500ms | 高 p95 > 1000ms | “Remark 阶段 p95 = Xms,超过阈值” |
cms_fragmentation |
GC 后堆占用低于 70% 却仍发生 Full GC——碎片化的空闲空间阻碍了连续分配。 | ≥ 3 次事件,GC 后平均 < 70% → 中 | “Full GC 后堆占用 X%——碎片化的空闲空间无法满足分配” |
ZGC 专属规则
仅在收集器被识别为 ZGC 时触发。
| 规则 ID | 触发条件 | 严重级别阈值 | 输出 |
|---|---|---|---|
zgc_allocation_stall |
分配请求被 GC 阻塞——ZGC 进入同步模式。仅为堆压力信号;与 reclaim_low 组合时才通过跨规则逻辑升级为 OOM(与 G1“Full GC + 无法回收”原则一致)。检测要求每阶段的 Y: Allocation Stalls: X Y Z W 行存在非零值、Critical: Allocation Stall 统计行非零,或存在 cause="Allocation Stall" 的事件——仅对标题文本做子串匹配会在计数全为零时误报。 |
≥ 1(真实停顿)→ 高 | “ZGC 进入同步模式——堆无法满足分配” |
zgc_pause_exceeds_target |
ZGC p99 停顿超过其亚毫秒级设计目标。 | 中 p99 > 1ms | 高 p99 > 5ms | “ZGC 停顿 Xms,超过目标” |
zgc_concurrent_cycle_failure |
ZGC 并发周期失败——通常由堆不足或分配速率过高导致。仅为堆压力信号;与 reclaim_low 组合时才升级为 OOM。 |
≥ 1 → 高 | “ZGC 并发周期失败——堆不足或分配速率过高” |
关键设计原则
- OOM = Full GC + 无法回收。 单次 Full GC 且回收率正常属于性能问题,不是 OOM。只有当 Full GC 与
reclaim_low(平均回收 < 5%)同时出现时,诊断才升级为 OOM 根因。这避免了System.gc()或一次性 heap dump 带来的误报。 - 手动触发不是堆压力。 当原因是
Heap Dump Initiated GC(jmap -dump / jcmd GC.heap_dump)或Heap Inspection(jcmd inspection)时,规则按有意为之,而非堆压力触发,严重级别上限为中,详情文本会明确说明。 System.gc()属于应用代码,不是堆压力。 原因为System.gc()、Heap Dump Initiated GC或Heap Inspection的 Full GC 被视为手动触发,不计入gc_frequency_high。生产环境可考虑用-XX:+DisableExplicitGC关闭,除非某些库(RMI、JMX 等)需要。专门的explicit_gc_called规则会以中(1-2 次)或高(≥ 3 次)级别触发,并直接建议排查调用代码——即使底层收集器(ZGC、G1、Parallel……)本身是健康的。- G1 手动/压力混合检测。 当日志同时包含手动触发(如
System.gc())与真实的堆压力 Full GC(如G1 Compaction Pause)时,g1_full_gc会给出专门的“混合”详情,分别列出两者的次数——让用户正确理解诊断,而不是把所有 Full GC 都归因于“堆压力”。 - CMS 规则默认归为性能问题。 CMS 本就允许 Full GC 兜底。仅
cms_concurrent_mode_failure与cms_promotion_failed时归为性能问题;只有与reclaim_low组合时才升级为 OOM。 - ZGC 硬兜底 → OOM 类别。 ZGC 不产生传统的 Full GC。其等价的硬兜底——
zgc_allocation_stall(同步模式)与zgc_concurrent_cycle_failure——默认归为性能问题;只有与reclaim_low(堆确实无法回收)组合时才升级为 OOM。这与应用于 G1 的“OOM = 无法回收”原则一致,也避免 ZGC 在高分配速率下正常运行时误报 OOM。 - 证据与症状。 发现按当前根因分为两层:证据 直接支撑根因;症状 是下游影响。这避免了不相关发现混在一起、难以阅读的扁平列表视图。
提示:每份报告在诊断下方都有一个可折叠的规则参考面板,列出全部 14 条规则及其阈值,无需离开应用即可查阅。
线程转储分析
如何采集线程转储
使用 jstack 命令采集经典文本格式(所有 JDK 版本):
jstack -l <pid> > threads.txt或使用 jcmd 采集 JSON 格式(JDK 21+,包含虚拟线程元数据):
jcmd <pid> Thread.dump_to_file -format=json threads.json也可以直接在 JVMind 中使用 jstack 标签页内置的采集工具(需要 agent 运行在你的 JVM 主机上)。
如何分析
- 打开分析面板(顶栏的 按钮)
- 选择 jstack 标签页
- 上传线程转储文件
- 让 AI 诊断:“找出这份线程转储中的死锁或锁竞争”
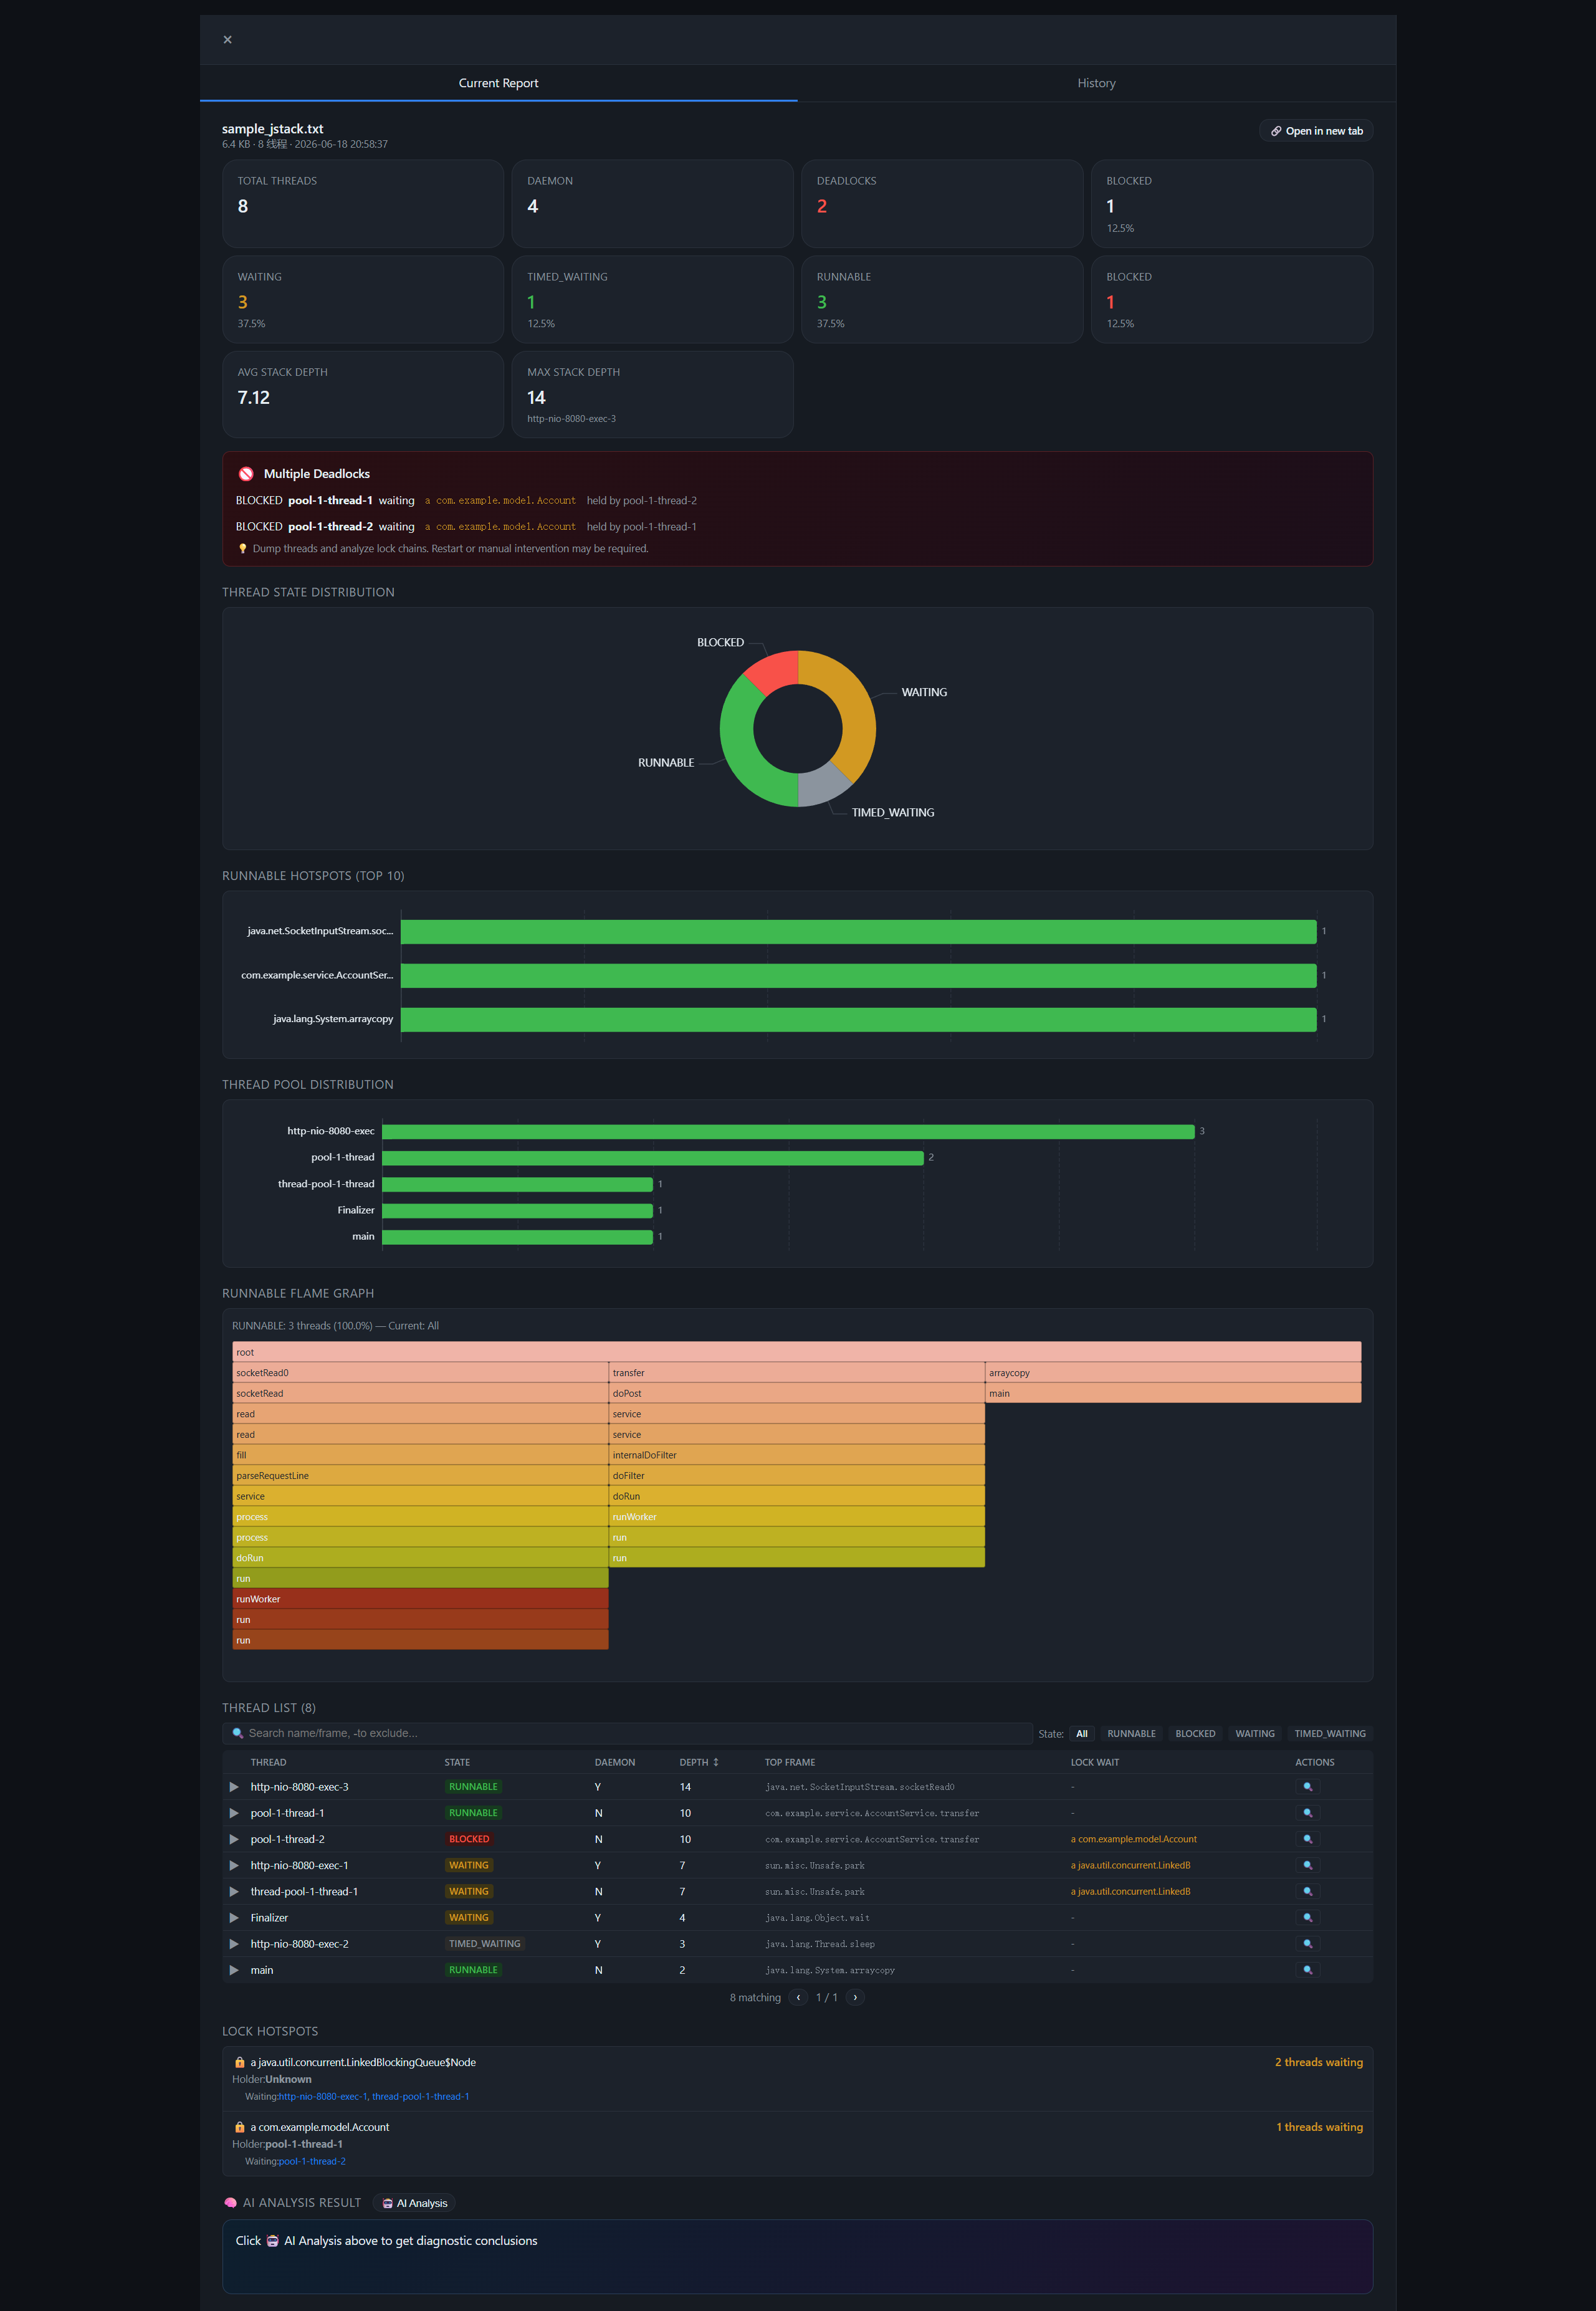
分析内容
- 线程状态分布——RUNNABLE、BLOCKED、WAITING、TIMED_WAITING 线程计数
- 死锁检测——自动发现循环死锁并展示完整等待链
- 锁竞争——定位造成阻塞最多的锁
- 线程分组——按名称前缀分组(如 Tomcat 工作线程、GC 线程)
- CPU 热点检测——哪些方法最频繁出现在 RUNNABLE 线程上
- 火焰图——所有堆栈的交互式火焰图
- 虚拟线程(仅 JSON)——虚拟线程数、TERMINATED 线程数,以及线程容器分布(ForkJoinPool.commonPool、ThreadPerTaskExecutor,……)。未命名虚拟线程会被合成为
VThread-<container>#<tid>以便分组。
可以这样提问
- “有死锁吗?给我看完整链路”
- “为什么 CPU 这么高?哪些线程在跑?”
- “检查有没有阻塞在同一把锁上的线程”
- “帮我理解这张火焰图——我应该优化什么?”
配置
LLM 设置
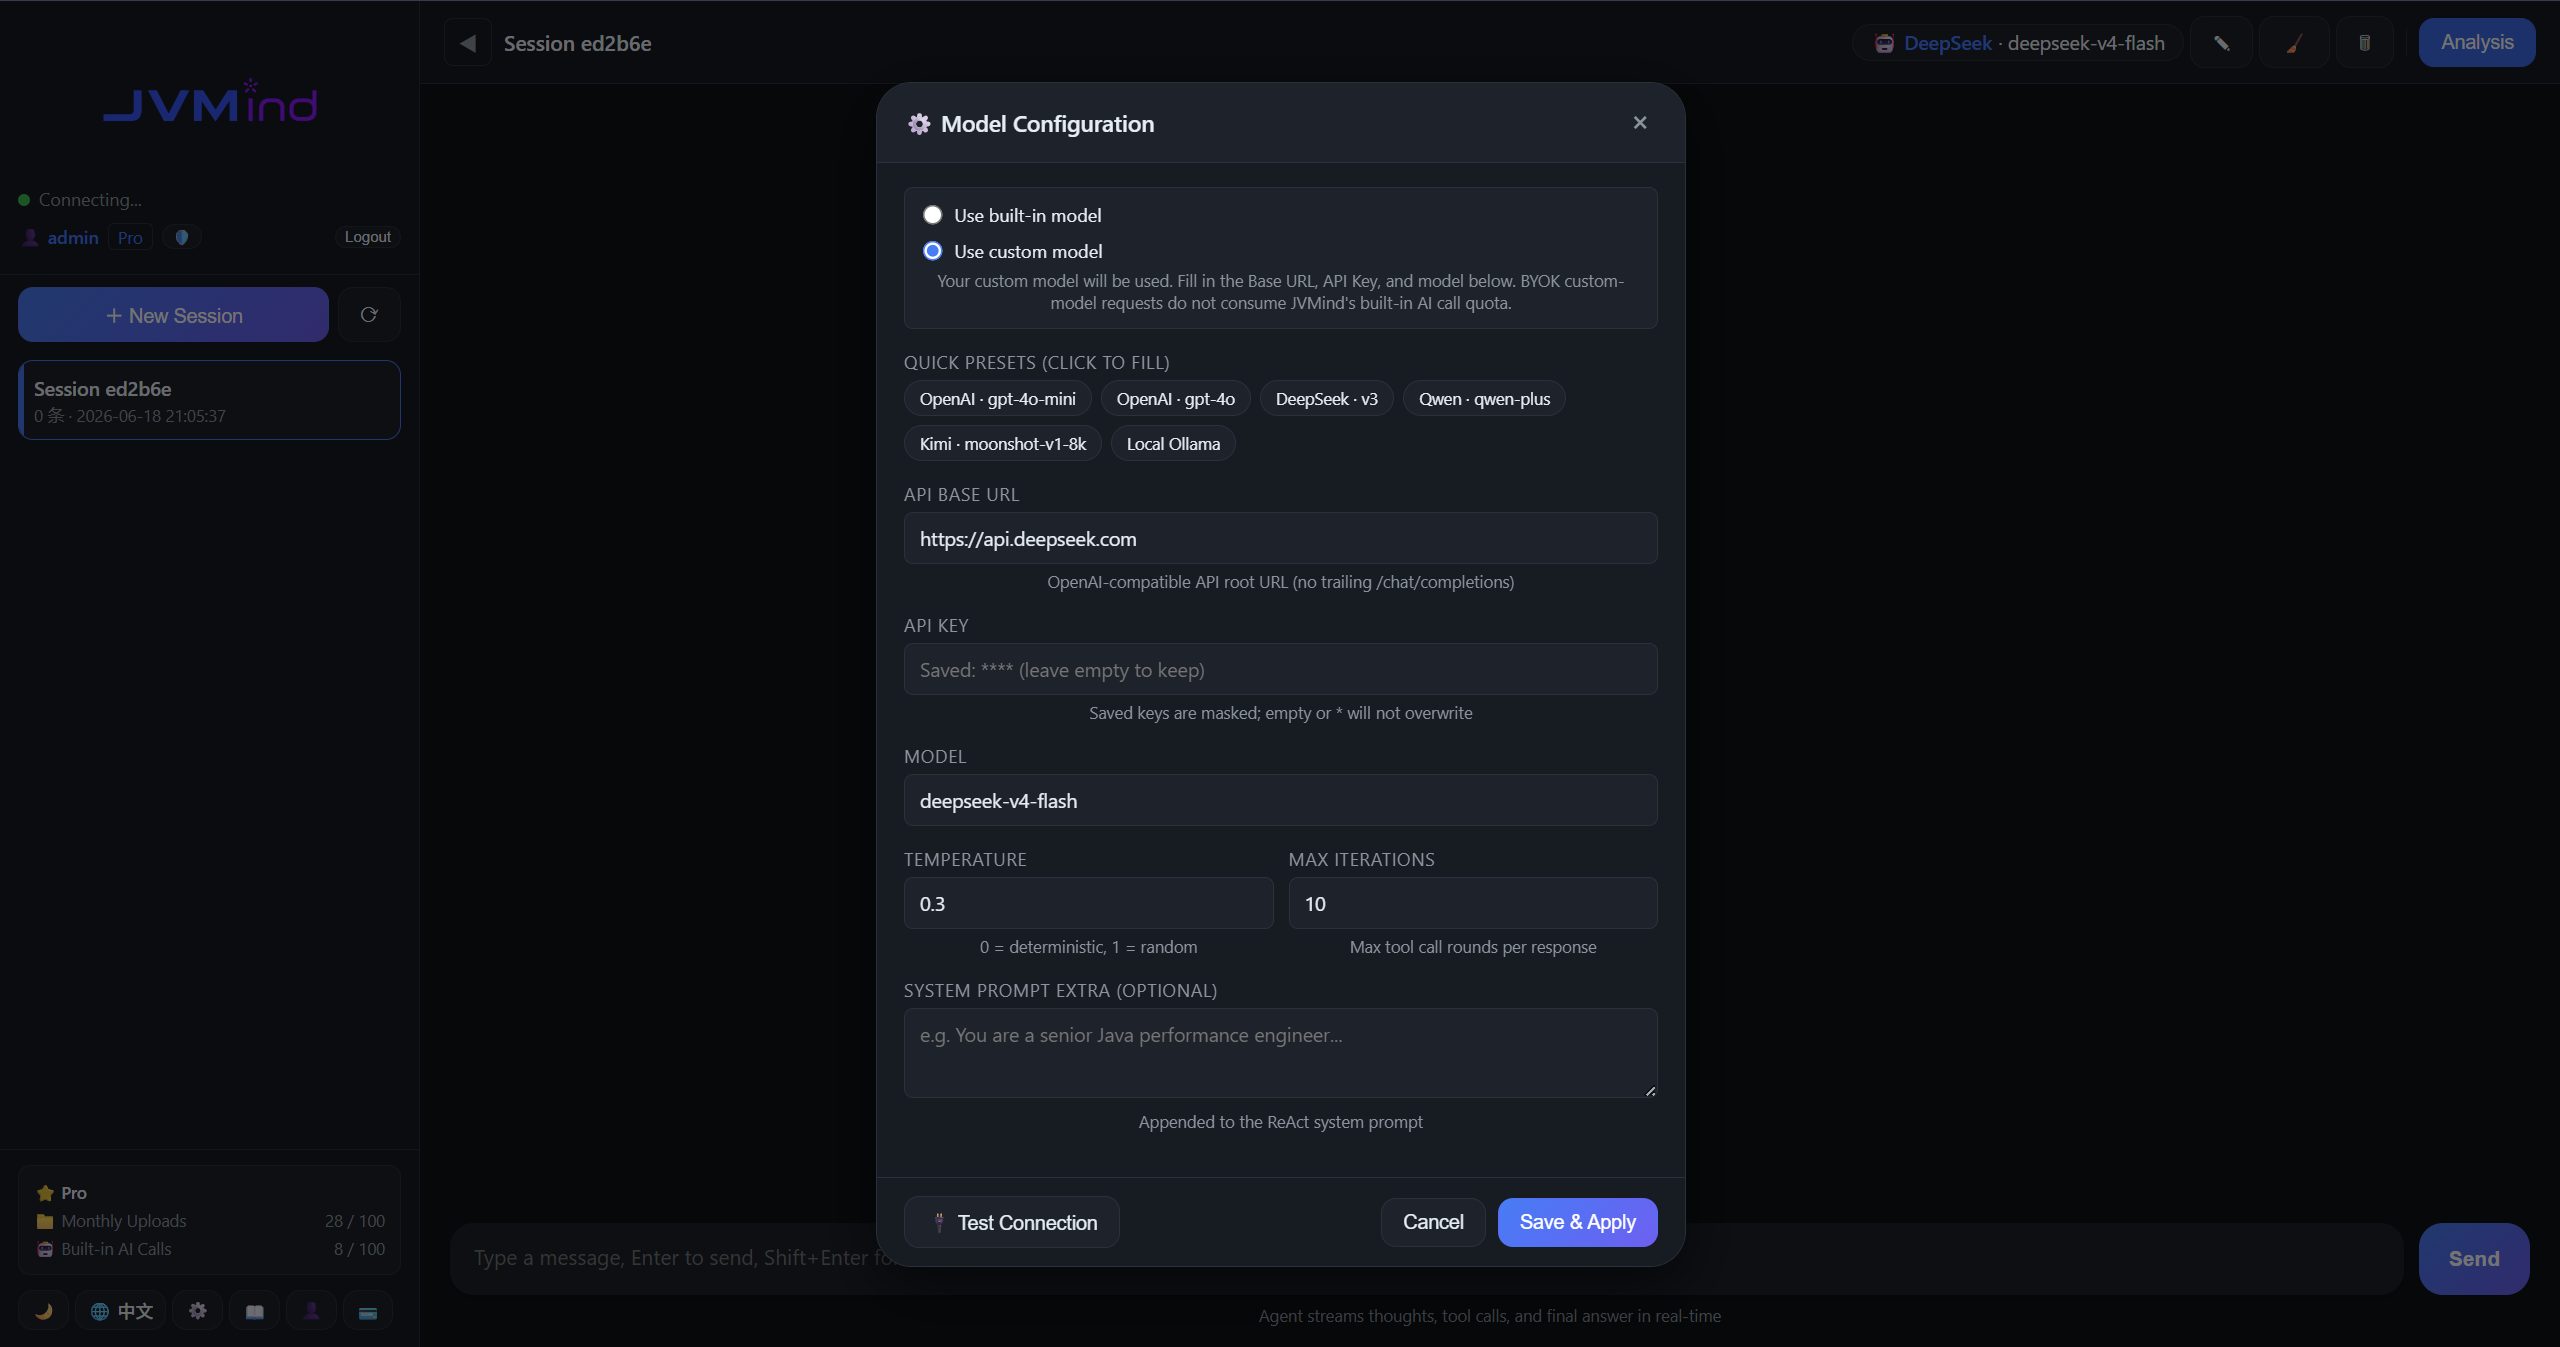
点击侧边栏的 按钮打开配置对话框:
| API Key | LLM 服务商的 API Key |
| Base URL | API 端点(自建或第三方服务商可自定义) |
| Model | 使用哪个模型(如 gpt-4o、deepseek-chat) |
| Temperature | 控制回答的创造性:越低越确定,越高越有创造性 |
| Max Iterations | AI 可执行的最大 ReAct 推理步数(越高越详尽,但更慢) |
| System Prompt | 用于引导 AI 行为的额外指令 |
保存后点击 “测试连接”,确认配置可用再开始对话。
支持的服务商
JVMind 内置了常见 LLM 服务商的预设:
- OpenAI — GPT-4o, GPT-4o-mini
- DeepSeek — deepseek-chat, deepseek-coder
- Alibaba Cloud — Qwen (通义千问)
- Moonshot — Kimi
对话指南
AI 如何思考
JVMind 采用 ReAct(推理 + 行动)框架。当你提问时,AI 会:
- 思考 它需要哪些信息
- 调用工具(例如分析 GC 日志、读取报告、做计算)
- 观察 结果
- 重复以上过程,直到掌握足够上下文给出完整回答
整个思考过程在对话中可见——你能清楚看到 AI 是如何得出结论的。
获得更好回答的技巧
- 问题要具体——“检查 Full GC 停顿时间是否导致延迟问题”比“GC 正常吗?”更好
- 先上传,再提问——先上传 GC 日志或 jstack 文件,再针对它提问
- 一次一个主题——每条消息聚焦一个问题,分析更清晰
- 善用记忆功能——在侧边栏记忆面板中添加应用相关信息,让 AI 跨会话记住它们
记忆
侧边栏的记忆面板让你保存希望 AI 记住的信息,例如:
- 你的 JVM 版本与堆大小
- 应用的流量特征
- 以往的优化尝试及其结果
AI 会在后续对话中自动引用已保存的信息,给出更贴合上下文的回答。
支持的格式
GC 收集器
| JVM 版本 | GC 收集器 | 支持 |
|---|---|---|
| JDK 8 | Serial, Parallel, CMS, G1 | |
| JDK 9+ | G1 | |
| JDK 9+ | Parallel / Serial | |
| JDK 12+ | Shenandoah | |
| JDK 11 — JDK 25 | ZGC (incl. Generational) |
线程转储格式
JVMind 支持两种线程转储格式,上传时自动识别:
- 文本(
jstack -l)——经典格式,适用于所有 JDK 版本。扩展名:.txt、.log、.tdump、.jstack。 - JSON(
jcmd Thread.dump_to_file -format=json)——JDK 21 引入,是查看虚拟线程细节(JEP 444)的唯一方式。扩展名:.json。额外提供虚拟线程、已终止线程与线程容器(executor / ForkJoinPool 分组)的统计。
文件必须为 UTF-8 编码(或纯 ASCII)。
ZGC 细节
JVMind 会累加同一 GC 周期内所有阶段的停顿时间,正确处理 ZGC 的多阶段停顿结构。同时识别旧版 Garbage Collection (System.gc()) 与 JDK 25+ 的 Major Collection (System.gc()) 格式,以检测由 System.gc() 触发的显式 Full GC。
常见问题
问:我的数据会发送给 AI 服务商吗?
分析结果(统计数据,而非原始文件)会发送给你配置的 LLM 用于诊断。原始文件保留在 JVMind 服务器上。
问:支持 Tomcat、Jetty 这类应用服务器吗?
支持——JVMind 适用于任何 Java 应用,与所用应用服务器或框架无关,只需要 GC 日志或线程转储。
问:很大的日志文件怎么办?
文件大小上限:加载中……。你当前套餐的上限会显示在应用侧边栏。
问:AI 诊断有多准确?
AI 提供的是可与资深性能工程师比肩的专业级分析。但在将关键建议应用到生产环境前,请务必自行核实,尤其是当日志缺少完整上下文时。
问:可以一次分析多个文件吗?
可以在同一个会话中上传多份 GC 日志或线程转储。它们都会出现在分析面板的历史记录中,AI 可以对比分析。
问:JVMind 支持滚动(rotating)的 GC 日志吗?
支持——可以逐个上传,也可以先合并成一个文件再上传。
问:在哪里可以了解每条诊断规则的含义?
见上方诊断规则一节——其中记录了全部 14 条规则、它们的阈值与根因类别。